Как Яндекс сократил расход GPU на ИИ-агента в 6,6 раза — и что это значит для малого бизнеса
Яндекс раскрыл инженерию агента «Исследовать»: как оптимизация обвязки, а не смена модели, снизила стоимость запроса в 6,6 раза и что это значит для бизнеса.
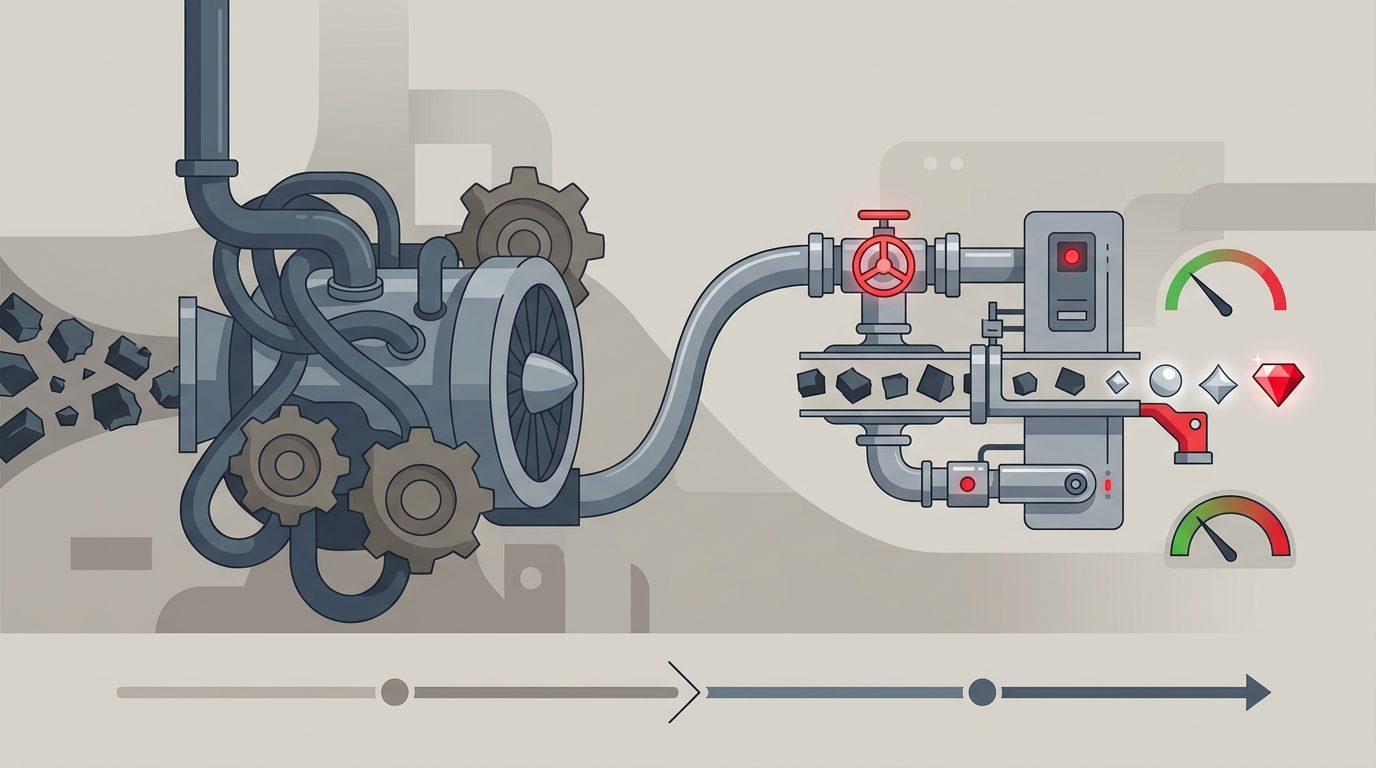
Яндекс рассказал, как за год построил исследовательского агента в составе Алисы AI — режим «Исследовать», по смыслу похожий на Deep Research у OpenAI. Публикацию написали руководитель команды и продакт-менеджер. В ней разобрана инженерная механика: как агент устроен внутри, почему модель не переобучали и почему стоимость одного запроса упала в 6,6 раза за три месяца.
На первый взгляд это техническая история для разработчиков. Но в ней есть три вещи, которые касаются любого владельца бизнеса, использующего ИИ-инструменты для работы с клиентами, контентом или аналитикой.
Первое: качество ответа ИИ часто определяет не модель, а обвязка вокруг неё — это меняет подход к выбору и настройке сервисов. Второе: стоимость ИИ-сервисов для конечного пользователя зависит не только от «ума» модели, но и от инженерии вокруг неё, а эта инженерия способна подешеветь за считаные месяцы. Третье: надёжность длинных ИИ-запросов, когда ответ готовится минутами, а не секундами, — не мелочь, а то, от чего зависит, выдержит ли сервис наплыв пользователей или откажет.
Что за агент и зачем он вообще нужен
Режим «Исследовать» в Алисе AI — инструмент для сложных запросов, на которые нельзя ответить одним поиском. По данным Яндекса, агент строит план решения задачи, делает сотни поисковых запросов, заходит на сайты (в том числе с динамическим содержимым на JavaScript), пишет и выполняет код на Python для расчётов, работает с загруженными файлами. Пример из публикации — запрос «спланируй путешествие в Дагестан на две недели на машине с детьми»: агент сам собирает маршрут, проверяет данные и складывает их в цельный ответ.
Первая версия отвечала по 30 минут, а иногда дольше. Это принципиально другой класс задач по сравнению с обычным чат-ботом, который выдаёт ответ за секунды. Именно из-за долгого времени ответа команде пришлось строить отдельную инфраструктуру: систему транспорта агентов (ATS) и инструментарий для многошаговых запросов с сотнями обращений к разным сервисам.
Для бизнеса здесь важна не техническая начинка, а класс задач, которые такой инструмент решает: не «напиши текст», а «собери и проверь информацию из десятков источников и дай структурированный вывод». Это ближе к работе аналитика или младшего маркетолога, чем к обычному чат-боту.
Главный вывод: обвязка важнее модели
Центральная мысль публикации формулируется коротко: качество ответа во многом определяет не сама языковая модель, а то, что вокруг неё построено. В индустрии это называют харнессом — совокупность оркестрации, работы с памятью и контекстом, проверок, повторных попыток, изоляции выполнения кода и системы наблюдения за тем, что происходит внутри. Отдельно есть термин скаффолдинг — заранее заданные шаблоны и схемы, по которым агент действует. Харнесс — это то, что выполняется в момент работы, скаффолдинг — то, что заложено на этапе проектирования.
Команда Яндекса показывает это на конкретных примерах. Классификатор релевантности, который отсекает мусорные фрагменты из поисковой выдачи перед тем, как отдать их модели, дал прирост на 9 процентных пунктов по бенчмарку BrowseComp. Обучение агента работать с файлами — PDF, таблицами, картинками — добавило 8,5 процентного пункта на бенчмарке GAIA. Отдельный инструмент для «продвинутого рассуждения» когда-то давал плюс 5 пунктов, но с выходом новых версий базовой модели начал мешать, и от него отказались.
Отсюда практический вывод. В публикации он сформулирован прямой цитатой — «99% работы делает сама модель, нам не нужен сложный фреймворк вокруг неё» — и отсылкой к известному в индустрии «Bitter Lesson» Ричарда Саттона: надстройки, придуманные под слабости конкретной модели, устаревают с каждым новым релизом. Поэтому харнесс нужно не только наращивать, но и регулярно срезать, проверяя пользу каждого компонента заново после обновления модели.
Для владельца бизнеса это значит: если вы сравниваете два ИИ-сервиса по названию модели внутри («на GPT» или «на другой модели»), это не главный критерий. Разница в качестве ответа чаще возникает из-за того, как сервис обработал ваш запрос, отфильтровал источники и проверил результат, а не из-за версии модели.
Как экономят на GPU — и почему это отражается на цене подписки
Отдельный блок публикации посвящён деньгам. Каждый лишний токен в контексте и каждый ненужный вызов модели — это расход дорогого вычислительного времени на видеокартах (GPU), а значит, ограничение на то, сколько пользователей сервис способен обслужить одновременно.
Яндекс перечисляет три шага, которые снизили расход:
- обработку поисковых фрагментов передали обученному классификатору вместо того, чтобы прогонять их через саму большую модель;
- агент стал обращаться к инструментам только тогда, когда это продвигает исследование, а не по умолчанию;
- генерацию плана исследования перевели на более лёгкую модель без потери качества.
В результате стоимость одного запроса упала в 6,6 раза за три месяца. Это не абстрактная цифра для отчёта: именно от такой экономии зависит, сможет ли сервис держать бесплатный тариф, снизить цену подписки или пережить резкий рост числа пользователей без сбоев.
Показательный эпизод из публикации — 9 мая, когда Яндекс запустил функцию поиска информации о родственниках-участниках Великой Отечественной войны через открытые архивы (ОБД «Мемориал», «Подвиг народа», «Память народа»). Наплыв пользователей оказался таким, что команде экстренно потребовались дополнительные вычислительные мощности, и их одолжила соседняя команда — на один день. Инфраструктура с чекпоинтами (сохранением состояния агента после каждого шага) позволила не терять прогресс пользователей даже при перегрузке серверов.
Для бизнеса, который планирует использовать ИИ-агентов в пиковые периоды — распродажи, праздники, всплески спроса, — этот эпизод показывает: надёжность длинных ИИ-запросов не гарантирована по умолчанию. Стоит уточнять у поставщика сервиса, что произойдёт с вашим запросом, если он выполняется несколько минут и в этот момент что-то отказывает на стороне провайдера.
Что это значит для небольшого бизнеса в России и СНГ
Прямого технического действия от владельца магазина или сервиса публикация не требует — вы не будете сами строить харнесс. Но из истории Яндекса можно вынести несколько практических выводов.
Первое: если вы используете ИИ-агентов для исследовательских задач — анализ конкурентов, сбор информации о поставщиках, подготовка справок для клиентов, разбор массива отзывов, — оценивайте не только «умный ли ИИ». Проверяйте, работает ли сервис с реальными файлами и сайтами, а не только с текстом в диалоге: разница в качестве ответа на сложный многошаговый запрос («найди всех поставщиков ткани с доставкой в мой регион и сравни цены») определяется именно инфраструктурой вокруг модели, а не громким названием.
Второе: не пугайтесь длинных ответов. Если сервис честно говорит, что исследование займёт несколько минут, это не признак того, что что-то ломается, — это признак того, что агент действительно проверяет источники, а не выдаёт первое попавшееся. Быстрый ответ на сложный вопрос про рынок, конкурентов или юридические нюансы часто менее надёжен, чем ответ, который собирался дольше.
Третье: закладывайте пиковые нагрузки в свои планы, если строите продукт или сервис на базе стороннего ИИ-агента — например, чат-бот на сайте с функцией «умного поиска» по каталогу. История с наплывом 9 мая показывает, что даже крупная компания с большой инфраструктурой может упереться в нехватку вычислительных мощностей в момент всплеска интереса. Если вы малый бизнес и подключаете сторонний ИИ-сервис к сайту или мессенджеру, узнайте у поставщика, что происходит с вашими клиентами при перегрузке — теряется ли диалог или сохраняется.
Четвёртое: следите за ценой на такие сервисы с оптимизмом, а не с подозрением. Публикация Яндекса показывает, что стоимость обработки одного запроса в сложных ИИ-агентах падает быстро — в разы за несколько месяцев — просто за счёт инженерной оптимизации, без удорожания или ухудшения базовой модели. Это значит, что подписки на такие инструменты со временем могут дешеветь или расширять бесплатные лимиты, а не только дорожать.
Пятое: если у вас есть штатный маркетолог или аналитик, которому приходится вручную собирать информацию из десятков источников — сравнение цен конкурентов, мониторинг отзывов, подбор поставщиков, — стоит на этой неделе протестировать режим глубокого исследования в доступных вам ИИ-сервисах на реальной рабочей задаче. Затраты времени на такую проверку минимальны, а выигрыш при удачном совпадении задачи и возможностей инструмента может освободить несколько часов ручной работы в неделю.
Итог
Публикация Яндекса интересна не столько описанием конкретного продукта, сколько прямым признанием того, что определяет качество ответа ИИ-агента на практике: не размер и не «умность» модели, а инженерная обвязка вокруг неё — фильтры, проверки, инструменты для работы с файлами и сайтами, механизм сохранения прогресса при сбоях. Эта обвязка одновременно снижает стоимость обработки запроса — в случае Яндекса в 6,6 раза за три месяца — и определяет, устоит ли сервис при резком росте числа пользователей.
Для бизнеса это два практических следствия: оценивать ИИ-сервисы стоит по тому, как они справляются с вашими реальными сложными задачами, а не по названию модели внутри, и закладывать в договорённости с поставщиками ИИ-инструментов вопрос устойчивости к пиковым нагрузкам — особенно если сервис завязан на клиентский сайт или продажи.